


Ein Architekturdiagramm bietet eine strukturierte Bauplan, die von Systemarchitekten und DevOps-Teams genutzt wird, um Infrastrukturaufbauten, Cloud-Mikroservices und strukturelle Layout-Konfigurationen zu visualisieren. Aufgebaut auf dem architecture-betaEngine ersetzt dieses textbasierte Werkzeug manuelle Zieh-Tools durch automatisches Anordnen von strukturellen Dienstgruppen, Datenbank-Clustern, Gateways und Edge-Pfaden zu sauberen, vorhersehbaren Systemlayouts.
Grundlegende Syntaxstruktur
Jedes Diagramm beginnt mit dem architecture-betaDeklarationskopf. Sie füllen die Leinwand aus, indem Sie einzelne Knotenelemente mit dem serviceSchlüsselwort definieren und Verbindungsverläufe festlegen, indem Sie exakte Richtungskoordinaten-Ports (Top, Bottom, Left, Right) angeben, die durch Doppelpunkte und Doppelpunkte getrennt sind.
architecture-beta
  service gateway(internet)[Gateway-Bezeichnung]
  service server(server)[App-Server]

  gateway:B -- T:server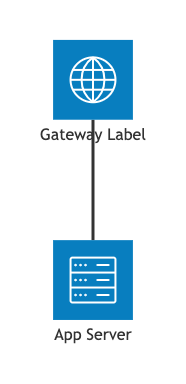
Syntax-Referenz
Die Tabelle unten zeigt die primären Datenkomponenten, Formatierungsschlüsselwörter und Verbindungsattribute, die zur Erstellung einer Architekturarbeitsplatzkarte in Mermaid.js verwendet werden.
| Syntaxkomponente | Typ-Anforderung | Beschreibung und Verwendungsregeln |
|---|---|---|
| Deklaration | Schlüsselwort-Bezeichner | Initialisiert die Arbeitsfläche für die Infrastrukturabbildung. Muss genau den architektur-beta block. |
| Dienstknoten | Schlüsselwort + Identitätsblock | Erklärt eine architektonische Entität. Verwendet die Syntax: dienst id(icon)[Anzeigelabel]. |
| Gruppenwrapper | Container-Schlüsselwort | Gruppiert verwandte Dienste innerhalb eines sichtbaren Containers. Verwendet die Syntax: gruppe id(icon)[Gruppenbeschriftung]. |
| In-Schlüsselwort | Zuweisungsmodifikator | Weist einen Dienstknoten explizit an, sich innerhalb eines bestimmten, deklarierten Gruppenwrappers zu befinden: dienst id(icon)[Beschriftung] in gruppenId. |
| Verzweigungsknoten | Schlüsselwort-Identifikator | Legt einen strukturellen Ausrichtungspunkt fest, der verwendet wird, um komplexe, mehrrichtungsgestaltete Verbindungswege ordentlich zu führen: verzweigung id. |
| Verbindungs-Kanten | Port-Richtungsoperatoren | Konfiguriert gerichtete Verfolgungspfade, indem die Verbindung an bestimmte Seiten des Knotens (T, B, L, R) angeheftet wird: quelle:seite -- seite:ziel. Unterstützt gerichtete Pfeilspitzen (-->). |
Erweiterte Gruppierung und Port-Kanten-Verlauf
Um genau zu steuern, wie Verbindungen zwischen Elementen verlaufen, ohne dass es unübersichtlich wirkt, erfordert die Architektur-Engine explizite Port-Bindungen. Verwandte Knoten können innerhalb struktureller Gruppen organisiert werden, um Systemgrenzen zu klären.
1. Genauere Port-Bindungsregeln
Sie definieren, wo eine Verbindungsleitung ein Komponenten verlässt und betritt, indem Sie einen Doppelpunkt und einen Kantenrichtungs-Flag (“T, B, L, R) an die jeweiligen Knotenbezeichnungen anhängen:
db:R -- L:server: Die Linie verlässt die **Rechte** der Datenbank und tritt an der **Linken** des Servers als gerade horizontale Linie ein.db:T -- L:server: Die Linie verlässt die **Obere** der Datenbank und tritt an der **Linken** des Servers ein, wobei sie automatisch an einem sauberen 90°-Knickwinkel abgebogen wird.src:B --> T:proc: Die Linie verlässt die **Untere** des Quellknotens und führt nach unten in die **Obere** des Prozessors mit einer gerichteten Pfeilspitze.
2. Strukturierung von Systemen mit Gruppen
Um eine visuelle Gruppe (z. B. ein virtuelles privates Netzwerk oder eine Datenbank-Cluster) zu deklarieren, verwenden Sie das groupSchlüsselwort und weisen Knoten über den inModifier zuordnen:
architecture-beta
  group cloudNetwork(cloud)[Privates Cloud]
    service auth(server)[Auth-Knoten] in cloudNetwork
    service api(server)[API-Endpunkte] in cloudNetwork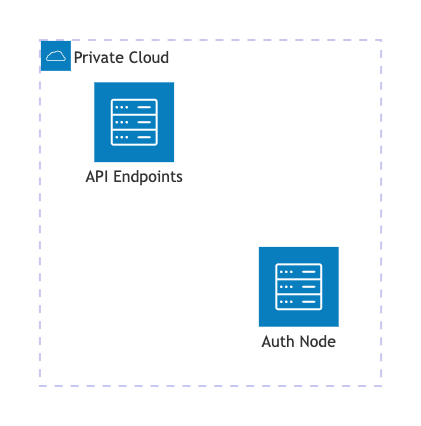
Ausrichten von Geschwister-Elementen (ab v11.16.0)
Wenn mehrere verschiedene Dienste identische Kantenrouting-Pfade teilen (z. B. drei entkoppelte Datenquellen, die in einen einzigen Nachrichtenworker streamen), kann der Layout-Algorithmus sie manchmal zusammenballen. Der align row und Spalte ausrichten Richtlinien zwingen die Engine, diese Geschwister-Elemente gleichmäßig entlang einer bestimmten Achse zu verteilen.
architektur-beta
  service src1(server)[Quelle 1]
  service src2(server)[Quelle 2]
  service proc(server)[Prozessor-Hub]

  src1:B --> T:proc
  src2:B --> T:proc

  Zeile ausrichten src1 src2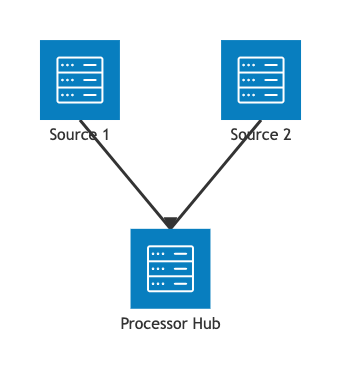
Realitätsnahe Bauplan: Der Bauplan für den Mikroservice-Cluster
Dieser Bauplan zeigt eine hochgradig widerstandsfähige, unternehmensrelevante Cloud-Architektur. Durch die Zentrierung der primären API-Engine und die horizontale Verzweigung von Authentifizierungs- und asynchronen Aufgaben zu beiden Seiten nutzt die Anordnung symmetrische Gestaltungsprinzipien, um überlappende Linien zu vermeiden. Der gesamte Datenfluss bewegt sich vorhersehbar von der öffentlichen Schnittstelle hinab in eine sauber ausgerichtete Datenspeicher-Ebene, wobei dual Zeile ausrichten Richtlinien, um Komponenten in scharfe, vorhersehbare horizontale Bahnen einzusperren.
architektur-beta
  title "Hochverfügbare Mikroservice-Architektur"

  %% Externe Eingangsebene
  service cloudflare(internet)[Cloudflare WAF]
  service alb(server)[AWS Application Load Balancer]

  %% Kernanwendungs-Cluster
  group appCluster(cloud)[Verwaltete EKS-Mikroservices]
    service authService(server)[Authentifizierungsdienst] in appCluster
    service apiService(server)[Kern-API-Engine] in appCluster
    service workerNode(server)[Asynchrone-Aufgaben-Arbeiter] in appCluster

  %% Gesicherte Speicherebene
  group dataCluster(database)[Geschützte Datenebene]
    service redis(disk)[Redis-Cache-Cluster] in dataCluster
    service postgres(database)[PostgreSQL-Primär] in dataCluster

  %% 1. Vertikaler Fluss: Datenverkehrseingang von außen hinab zum Rechenkern
  cloudflare:B --> T:alb
  alb:B --> T:apiService

  %% 2. Horizontaler Fluss: Kern-API verzweigt sich symmetrisch nach links und rechts
  apiService:L --> R:authService
  apiService:R --> L:workerNode

  %% 3. Basisebene: App-Arbeiter fallen direkt in die jeweiligen Datenslots
  authService:B --> T:redis
  workerNode:B --> T:postgres

  %% Ausrichtung der Layout-Achsen für ein perfektes Raster
  Zeile ausrichten authService apiService workerNode
  Zeile ausrichten redis postgres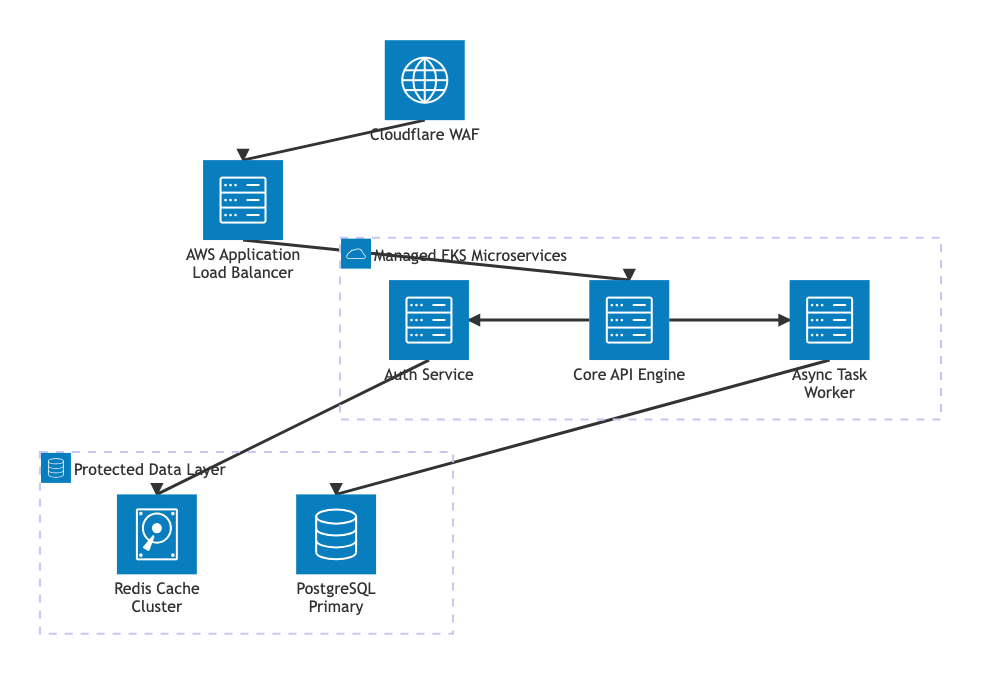
Häufige Syntax-Fehler & Systembeschränkungen
Beim Schreiben von Infrastrukturcode sollten diese spezifischen Regeln zur Konfigurationsvalidierung beachtet werden, um Parsing-Fehler zu vermeiden:
- Reihenfolge der Label-Klammern:Anzeigetextzeichenfolgen müssen eckige Klammern verwenden
[Label-Text]und folgen unmittelbar nach den Icon-Klammern ohne Leerzeichen:service id(server)[Text]ist korrekt. Die Verwendung von Anführungszeichen innerhalb der Klammern bricht den Parser. - Groß-/Kleinschreibung der Anschlüsse: Ankerpunkte für Verbindungs-Kanten müssen in Großbuchstaben geschrieben werden (
T,B,L,R). Kleinbuchstaben (t,b,l,r) werden nicht erkannt und führen zu Abstürzen beim Generieren der Anordnung. - Regel vor der Deklaration: Jeder Knoten- oder Verzweigungsbezeichner, der innerhalb einer Kantenpfad-Anweisung verwendet wird, muss ausdrücklich in einer separaten Zeile darüber deklariert werden. Eine Verbindung zu einem impliziten Knotennamen wird nicht erfolgreich gebaut.
- Grenzen für Ausrichtungsmitglieder: Wenn die
align rowoderalign columnAusrichtungsanweisungen müssen mindestens zwei oder mehr gültige, zuvor deklarierte Dienst- oder Verzweigungsbezeichner in der Befehlszeile angegeben werden.